
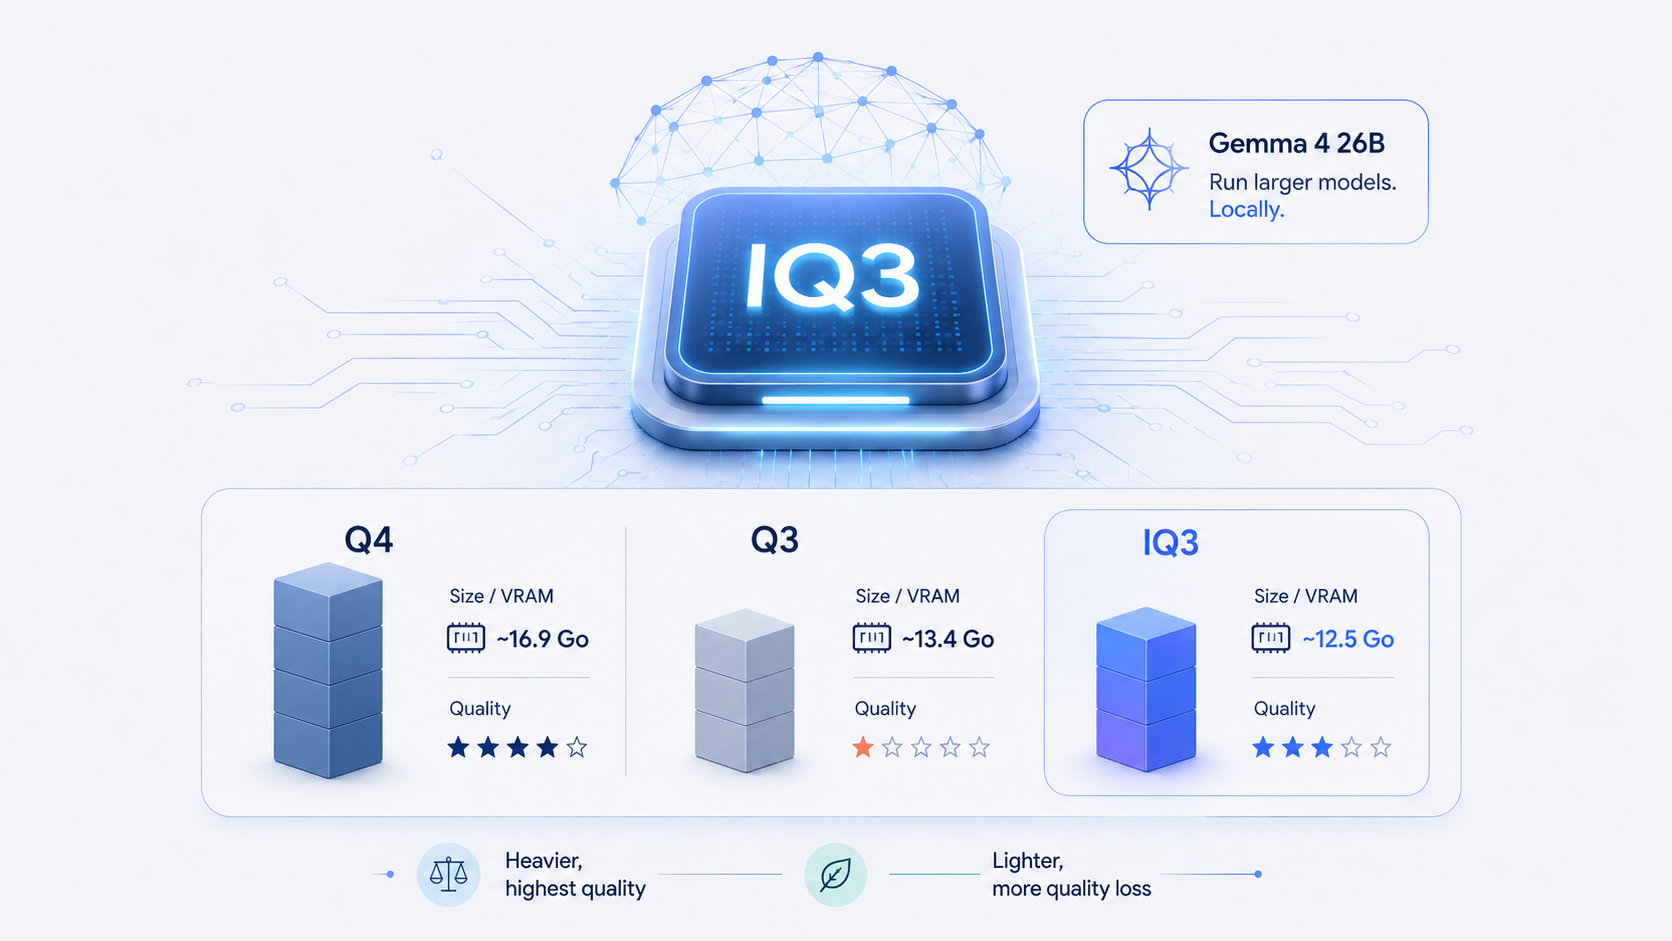
Faire fonctionner localement un modèle d’intelligence artificielle de plusieurs dizaines de milliards de paramètres reste avant tout une question de mémoire disponible.
Un modèle de 20, 30 ou 40 milliards de paramètres utilisé dans sa précision d’origine peut rapidement nécessiter plusieurs dizaines de gigaoctets de RAM ou de VRAM. C’est précisément pour résoudre ce problème que la quantification est devenue un élément essentiel de l’écosystème de l’IA locale.
Après les classiques Q8, Q6, Q5, Q4 ou Q3, une famille de quantifications attire particulièrement l’attention lorsqu’il faut réduire fortement la taille d’un modèle : les I-Quants, et notamment IQ3.
Avec une taille proche de 3 bits par poids, IQ3 permet aujourd’hui de charger des modèles importants sur du matériel grand public, tout en conservant une qualité sensiblement supérieure à certaines quantifications Q3 traditionnelles de taille équivalente.
L’arrivée de modèles comme Gemma 4 26B A4B illustre parfaitement l’intérêt de cette approche.
Pourquoi quantifier un modèle ?
Les paramètres d’un modèle sont initialement stockés avec une précision relativement élevée, généralement en FP16 ou BF16.
En simplifiant, si chaque paramètre nécessite 16 bits, un modèle de 26 milliards de paramètres représente déjà théoriquement plus de 50 Go uniquement pour ses poids.
La quantification consiste à représenter ces valeurs avec moins de bits.
Passer de 16 bits à environ 4 bits permet donc de réduire considérablement la mémoire nécessaire. Descendre vers 3 bits permet d’aller encore plus loin.
Le problème est évident : plus la précision diminue, plus on risque de dégrader les informations contenues dans les poids du réseau neuronal.
La difficulté consiste donc à trouver le meilleur compromis :
réduire fortement la taille sans détériorer excessivement le modèle.
C’est précisément sur ce terrain que les quantifications IQ deviennent intéressantes.
Q3 classique et IQ3 : ce n’est pas exactement la même chose
Les quantifications Q3_K utilisées depuis plusieurs années dans llama.cpp réduisent les poids du modèle en utilisant différents groupes et niveaux de précision.
On rencontre notamment : Q3_K_S, Q3_K_M, Q3_K_L.
Les variantes IQ3 utilisent une approche plus sophistiquée, basée notamment sur des méthodes de quantification non linéaires et sur une importance matrix, ou imatrix.
Cette matrice est générée en faisant fonctionner le modèle sur un corpus de calibration. Elle permet d’identifier les poids dont la précision est particulièrement importante pour préserver le comportement du modèle.
L’idée est finalement assez intuitive : plutôt que de traiter tous les poids exactement de la même manière, la quantification tient davantage compte de leur impact réel sur le résultat.
On retrouve plusieurs variantes :
IQ3_XXS → IQ3_XS → IQ3_S → IQ3_M
La taille augmente progressivement, tout comme la fidélité au modèle original.
Un exemple concret avec Gemma 4 26B
Gemma 4 26B A4B est particulièrement intéressant pour l’IA locale.
Il possède environ 25,2 milliards de paramètres, mais utilise une architecture Mixture-of-Experts : seulement environ 3,8 milliards de paramètres sont activés pour chaque token généré. L’ensemble des poids doit toutefois toujours être chargé en mémoire.
Google estime ainsi qu’une version BF16 nécessite approximativement 57,7 Go de mémoire, contre environ 14,4 Go pour une version Q4_0, valeurs incluant une marge de chargement de 20 %.
Les fichiers GGUF communautaires donnent une autre vision très concrète du phénomène.
Pour Gemma 4 26B A4B, on trouve actuellement approximativement :
| Quantification | Taille du GGUF |
|---|---|
| Q8_0 | 27,0 Go |
| Q6_K | 22,7 Go |
| Q5_K_M | 19,2 Go |
| Q4_K_M | 16,9 Go |
| Q4_K_S | 15,6 Go |
| IQ4_XS | 14,0 Go |
| Q3_K_L | 13,9 Go |
| Q3_K_M | 13,4 Go |
| IQ3_M | 12,5 Go |
| IQ3_S | 12,3 Go |
| IQ3_XS | 11,7 Go |
| IQ3_XXS | 11,4 Go |
Ces valeurs proviennent des quantifications utilisant une importance matrix disponibles pour Gemma 4 26B.
Le constat est particulièrement intéressant. Une version IQ3_M de Gemma 4 26B occupe environ 12,5 Go, contre environ 16,9 Go en Q4_K_M. Cela représente environ 26 % de mémoire en moins.
Par rapport au Q3_K_M, IQ3_M gagne encore environ 900 Mo, soit autour de 7 %.
Pour une machine équipée de 16 Go de VRAM ou pour une configuration utilisant RAM et VRAM conjointement, ces quelques gigaoctets peuvent faire toute la différence entre un modèle qui peut être chargé confortablement et un autre qui devient difficilement exploitable.
Mais quelle perte de précision ?
C’est évidemment la question essentielle. La taille du fichier ne veut rien dire si la réduction détruit les capacités du modèle. Pour mesurer l’effet de la quantification, llama.cpp utilise notamment la perplexité. Cette métrique mesure la capacité du modèle à prédire le token suivant : plus la valeur est faible, meilleur est le résultat.
Elle ne constitue pas un benchmark absolu de l’intelligence d’un modèle, mais elle est particulièrement utile pour comparer un même modèle avant et après quantification.
Les tests publiés par llama.cpp sur Llama 3 8B permettent d’obtenir un bon ordre de grandeur.
La version FP16 atteint une perplexité de 6,233.
Avec une importance matrix :
| Quantification | Taille | Perplexité | Hausse par rapport au FP16 |
| FP16 | 14,97 Gio | 6,233 | référence |
| Q4_K_M | 4,58 Gio | 6,383 | +2,4 % |
| Q3_K_M | 3,74 Gio | 6,734 | +8,0 % |
| IQ3_M | 3,53 Gio | 6,898 | +10,7 % |
| IQ3_S | 3,42 Gio | 6,966 | +11,8 % |
| Q3_K_S | 3,41 Gio | 7,603 | +22,0 % |
Données issues du scoreboard officiel de llama.cpp.
Et c’est ici que l’intérêt d’IQ3 apparaît réellement.
IQ3 ne bat pas toujours Q3… mais il est beaucoup plus efficace à taille équivalente
À première vue, le tableau pourrait surprendre. Q3_K_M obtient ici une perplexité légèrement meilleure qu’IQ3_M.
Il serait donc incorrect d’affirmer que IQ3 est systématiquement plus précis que toutes les variantes Q3.
Mais comparons ce qui est réellement comparable.
IQ3_S et Q3_K_S occupent pratiquement exactement la même place : 3,42 contre 3,41 Gio.
Pourtant :
- IQ3_S : 6,966 de perplexité ;
- Q3_K_S : 7,603.
La dégradation par rapport au FP16 passe ainsi d’environ 22 % avec Q3_K_S à moins de 12 % avec IQ3_S.
Autrement dit, pour pratiquement la même quantité de mémoire, la hausse de perplexité est presque divisée par deux.
C’est là que les I-Quants prennent tout leur sens.
Même les créateurs de quantifications Gemma 4 disponibles sur Hugging Face signalent par exemple que IQ3_S surpasse les Q3_K à cette gamme de taille, tandis qu’IQ3_XS est généralement préférable à Q3_K_S lorsque la mémoire devient particulièrement contrainte.
Q4 reste cependant la référence lorsque la mémoire le permet
Il ne faut pas transformer IQ3 en solution miracle.
Les données de llama.cpp montrent encore clairement qu’un bon Q4_K_M conserve davantage de précision.
Sur le benchmark précédent :
- Q4_K_M : environ +2,4 % de perplexité ;
- Q3_K_M : environ +8 % ;
- IQ3_M : environ +10,7 %.
Si vous disposez de suffisamment de RAM ou de VRAM, Q4_K_M reste donc généralement un excellent choix pour privilégier la fidélité au modèle original.
IQ3 répond à une autre problématique :
Jusqu’où peut-on réduire un modèle sans franchir le seuil où sa qualité devient réellement problématique ?
Et sur ce terrain, son rapport qualité/taille est particulièrement intéressant.
Un grand modèle en IQ3 ou un plus petit modèle en Q4 ?
C’est peut-être finalement la question la plus intéressante pour l’IA locale.
Imaginons une machine disposant d’environ 16 Go de mémoire exploitable.
On pourrait choisir :
- un modèle d’environ 12 milliards de paramètres en Q5 ou Q6 ;
- un modèle plus important en Q4 ;
- ou un modèle de 25 à 30 milliards de paramètres en IQ3.
Le dernier choix peut se révéler particulièrement pertinent pour certaines tâches.
La quantification diminue la précision avec laquelle les poids sont représentés, mais elle ne supprime pas les connaissances, l’architecture ou les capacités acquises pendant l’entraînement.
Un modèle de 26 milliards de paramètres légèrement quantifié conserve donc parfois des capacités qu’un modèle beaucoup plus petit ne possède tout simplement pas.
Cela ne signifie évidemment pas qu’un 26B IQ3 sera systématiquement meilleur qu’un excellent 12B Q6.
Mais IQ3 change considérablement les possibilités offertes par une quantité donnée de mémoire.
Gemma 4 26B : un cas particulièrement intéressant
Gemma 4 26B combine d’ailleurs deux mécanismes particulièrement intéressants pour l’IA locale.
Le premier est son architecture Mixture-of-Experts.
Même s’il possède environ 25,2 milliards de paramètres au total, seuls environ 3,8 milliards sont activés pour chaque token. Google indique ainsi que le modèle fonctionne, en termes de calcul d’inférence, beaucoup plus près d’un modèle de 4 milliards de paramètres que d’un modèle dense de 26 milliards.
Le second est précisément la quantification.
Avec environ 12,3 à 12,5 Go pour IQ3_S ou IQ3_M, il devient possible d’envisager un modèle de cette catégorie sur des configurations relativement ordinaires.
On parle ici d’un modèle qui atteint, dans sa version complète, 82,6 % sur MMLU-Pro, 88,3 % sur AIME 2026 et 82,3 % sur GPQA Diamond.
Évidemment, ces scores correspondent au modèle de référence et ne doivent pas être présentés comme les performances garanties de sa version IQ3.
Mais ils donnent une idée de la catégorie de modèle que cette technique permet désormais d’amener sur du matériel local.
Attention également à la fenêtre de contexte
La taille du fichier GGUF n’est pas synonyme de mémoire totale nécessaire.
Il faut également prévoir :
- le cache KV ;
- la fenêtre de contexte utilisée ;
- les buffers du moteur d’inférence ;
- éventuellement les composants multimodaux ;
- ainsi que la mémoire utilisée par le système.
Gemma 4 26B supporte par exemple un contexte pouvant atteindre 256 000 tokens. Utiliser réellement une telle fenêtre demande évidemment beaucoup plus de mémoire qu’une utilisation avec 4 096, 8 192 ou 16 384 tokens.
Un modèle de 12,5 Go ne signifie donc pas automatiquement qu’une carte graphique de 12 Go pourra le charger intégralement.
En revanche, avec llama.cpp et les différentes possibilités de répartition CPU/GPU, ces quantifications ouvrent des configurations auparavant difficiles à envisager.
IQ3 : particulièrement pertinent pour l’IA locale
IQ3 ne remplace donc pas Q4. Il apporte plutôt un nouvel étage dans le compromis entre taille et qualité.
Lorsque la mémoire est suffisante, Q4_K_M ou des quantifications supérieures restent naturellement préférables.
Lorsque chaque gigaoctet compte, IQ3 devient beaucoup plus intéressant.
En particulier, IQ3_S et IQ3_M permettent de réduire fortement la taille d’un modèle tout en évitant la détérioration beaucoup plus importante que l’on peut observer avec certaines quantifications Q3 traditionnelles très compactes.
Pour Gemma 4 26B, cela signifie concrètement pouvoir passer d’environ 16,9 Go en Q4_K_M à seulement 12,5 Go en IQ3_M.
Quatre gigaoctets gagnés peuvent paraître anecdotiques sur un serveur équipé de plusieurs GPU professionnels.
Sur une machine personnelle équipée de 16 Go de VRAM, ils changent complètement la donne.
Une évolution importante pour la démocratisation de l’IA locale
Pendant longtemps, utiliser un modèle plus important signifiait presque mécaniquement acheter davantage de mémoire ou du matériel beaucoup plus coûteux.
Les nouvelles techniques de quantification commencent progressivement à casser cette relation.
Elles ne rendent évidemment pas la mémoire gratuite et elles impliquent toujours un compromis sur la précision.
Mais les I-Quants montrent qu’il est possible de mieux utiliser chaque bit disponible.
Dans le domaine de l’IA locale et open source, cette évolution est probablement aussi importante que l’augmentation permanente du nombre de paramètres.
Car le modèle le plus intéressant n’est pas nécessairement celui qui obtient le meilleur benchmark sur une infrastructure professionnelle. C’est aussi celui que l’on peut réellement faire fonctionner sur sa propre machine.
Et avec IQ3, la frontière entre les deux continue clairement de se rapprocher.