Ministral 3 ou Gemma 4 : quelles différences pour une IA locale ?
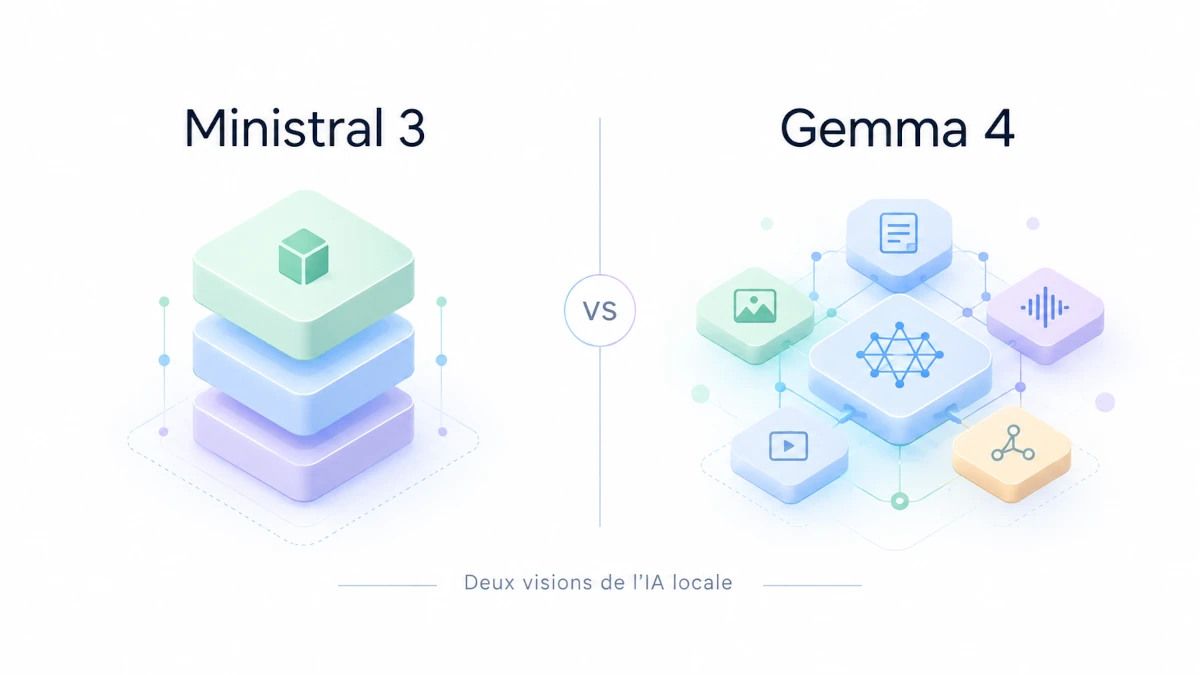
Lorsqu’on cherche aujourd’hui un modèle d’intelligence artificielle capable de fonctionner directement sur un ordinateur personnel, deux familles méritent particulièrement l’attention : Ministral 3, développée par Mistral AI, et Gemma 4, conçue par Google DeepMind. Toutes deux proposent des modèles ouverts pouvant être exécutés localement, y compris sur du matériel grand public. Elles prennent également en … Lire la suite
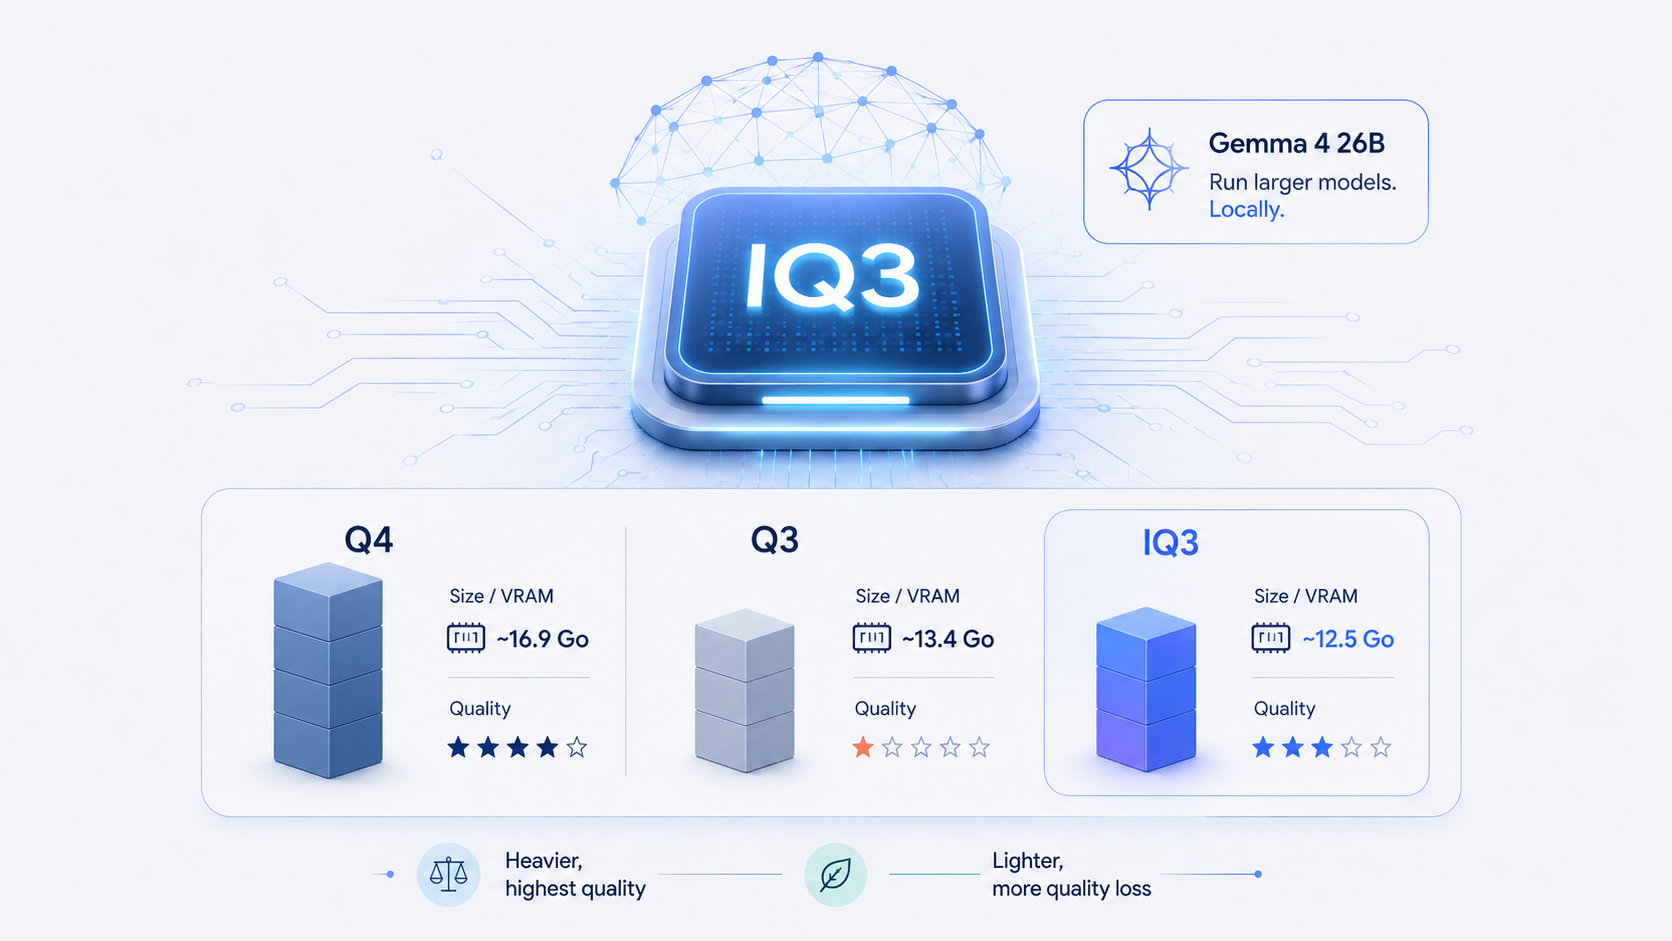
Quantification IQ3 : faire tourner de grands modèles IA avec beaucoup moins de mémoire

Faire fonctionner localement un modèle d’intelligence artificielle de plusieurs dizaines de milliards de paramètres reste avant tout une question de mémoire disponible. Un modèle de 20, 30 ou 40 milliards de paramètres utilisé dans sa précision d’origine peut rapidement nécessiter plusieurs dizaines de gigaoctets de RAM ou de VRAM. C’est précisément pour résoudre ce problème … Lire la suite

Faut-il vraiment laisser les modèles IA open-weight accessibles à tout le monde ? Le débat s’intensifie aux États-Unis

Pendant plusieurs années, la publication ouverte des modèles d’intelligence artificielle a surtout été présentée comme une question d’innovation, de transparence et de démocratisation technologique. En 2026, le débat change progressivement de nature. Aux États-Unis, responsables politiques, chercheurs et entreprises technologiques commencent désormais à se poser une question beaucoup plus délicate : Faut-il continuer à permettre … Lire la suite

Pourquoi le laboratoire IA Open Source ne teste pas les modèles Qwen et Llama

Depuis plusieurs mois, les modèles de la famille Qwen, développés par Alibaba, occupent régulièrement les premières places des classements de performances. Rapides, souvent très compétitifs et disponibles sous des licences ouvertes pour certaines versions, ils attirent naturellement l’attention de nombreux utilisateurs. Pourtant, vous remarquerez qu’au laboratoire IA Open Source, nous avons fait un choix assumé … Lire la suite

Faut-il vraiment changer de GPU tous les deux ans pour faire de l’IA locale ?

À chaque nouvelle génération de cartes graphiques, la même question revient : faut-il investir dans un nouveau GPU pour continuer à faire tourner les derniers modèles d’IA ? Contrairement aux idées reçues, l’évolution des modèles d’IA ne signifie pas forcément qu’il faut changer de matériel tous les deux ans. Au contraire, les progrès réalisés avec … Lire la suite

Ministral 3 14B : notre évaluation après plusieurs campagnes de tests

Ministral 3 14B est le modèle le plus ambitieux de la famille Ministral actuellement évalué par le laboratoire IA Open Source. Avec ses 14 milliards de paramètres, il s’adresse aux utilisateurs recherchant un niveau d’analyse supérieur pour des usages tels que la recherche documentaire, l’exploitation de corpus volumineux ou l’ingestion de contenus web complexes. Contrairement … Lire la suite

Ministral 3 8B : notre évaluation après plusieurs campagnes de tests

Ministral 3 8B est un modèle de langage open source de dernière génération développé par Mistral AI. Avec ses 8 milliards de paramètres, il occupe une position particulièrement intéressante entre les modèles très compacts, destinés aux configurations modestes, et les modèles plus volumineux qui nécessitent davantage de ressources matérielles. Dans le cadre du laboratoire IA … Lire la suite

L’overdose d’IA : faut-il vraiment mettre des agents intelligents partout ?

Depuis quelques mois, une véritable déferlante d’intelligence artificielle s’abat sur le monde numérique. Chaque semaine apporte son lot d’annonces : agents IA, assistants autonomes, IA dans les moteurs de recherche, IA dans les navigateurs, IA dans les logiciels bureautiques, IA dans les smartphones, IA dans les réfrigérateurs, et bientôt peut-être dans les grille-pains… À croire … Lire la suite

Pourquoi notre labo IA privilégie les GPU AMD pour ses tests ?

Lorsqu’on parle d’intelligence artificielle locale, NVIDIA est souvent considéré comme le choix par défaut. La majorité des tutoriels, des benchmarks et des projets d’IA sont d’ailleurs réalisés sur des cartes graphiques NVIDIA. Pourtant, au sein de notre laboratoire IA, nous avons fait un choix différent : réaliser l’essentiel de nos tests sur des GPU AMD. … Lire la suite