
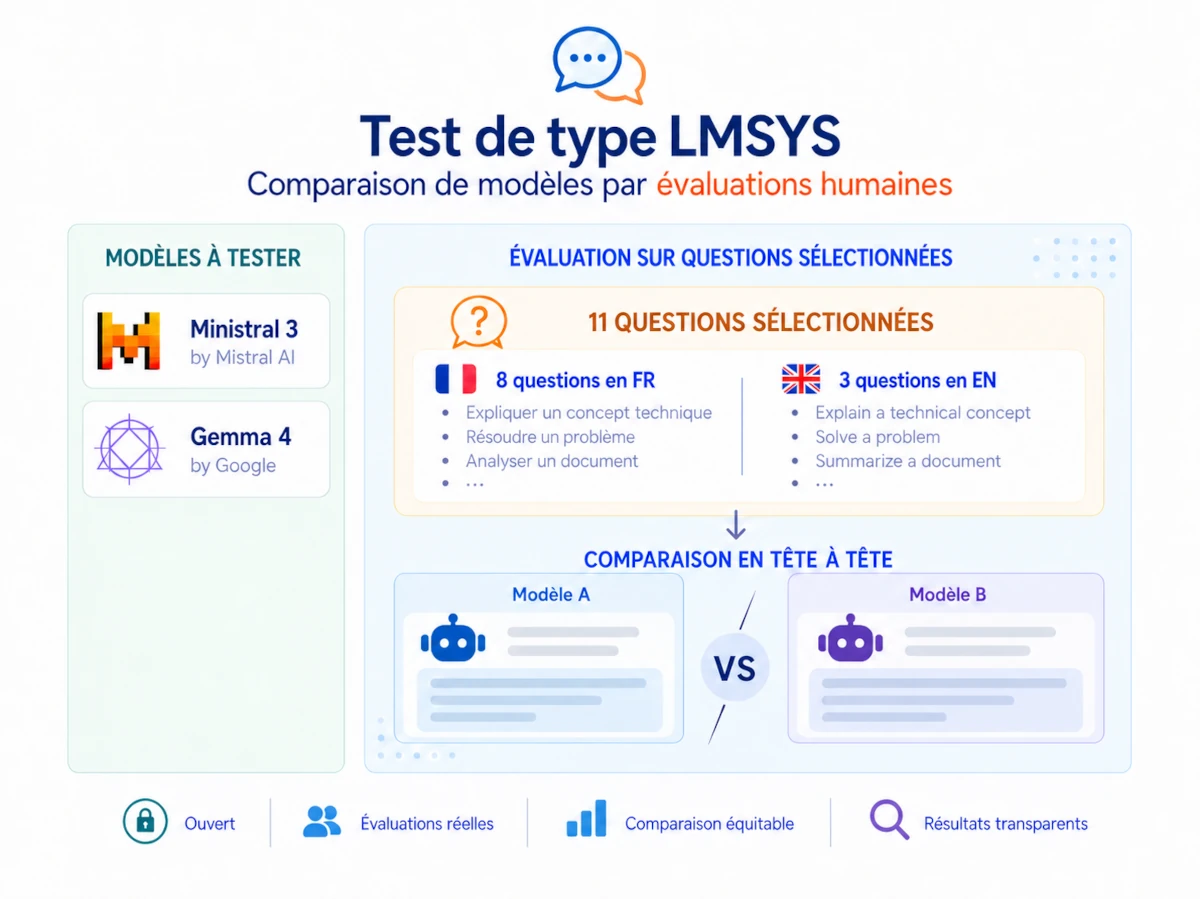
Test de type LMSYS · Évaluation du raisonnement général · Mode chat sans corpus · Ministral 3 14B sur Serveur IA.
| Modèle | Ministral 3 14B |
|---|---|
| Éditeur | Mistral AI |
| Environnement | Ollama + AnythingLLM · mode chat, sans workspace documentaire |
| Protocole | LMSYS · 8 questions cœur (FR) + set de contrôle bilingue (3 questions EN) |
| Prompt système | Assistant généraliste, clause anti-invention (version FR pour les questions FR, version EN pour le set EN) |
| Température | 0.3 · fixe pour toutes les questions |
| Conversations | Une conversation neuve par question · set EN dans une session distincte |
| Date du test | 11/10/2026 |
| Langues | Français · Anglais |
| Machine | Serveur IA |
|---|---|
| CPU | Ryzen 5 9600X |
| RAM | 32 Go DDR5 |
| GPU | RX 9060 XT · 16 Go VRAM |
| OS | Linux Mint 22 |
| Paramètre | Valeur observée |
|---|---|
| Débit | 29,16 à 30,44 tok/s sur les 11 réponses (très stable) |
| Durée des réponses | 1,7 s (Q5) à 23,2 s (Q8), proportionnelle à la longueur de la réponse |
| Raisonnement visible | Aucun mode Thinking affiché |
| Passes | Passe unique par question : un résultat limite peut varier d’un essai à l’autre |
Questions et réponses (FR)
Q1 – Logique Question : Alice, Bruno et Carla ont chacun un animal différent (chat, chien, poisson). Alice n’a ni le chat ni le poisson. Bruno n’a ni le chien ni le poisson. Qui possède quel animal ?
Réponse : Le modèle attribue d’abord le chien à Alice, puis affirme que Bruno n’a aucun animal et que l’énoncé est contradictoire. Il se corrige ensuite en cours de réponse et livre la solution complète : Alice a le chien, Bruno le chat, Carla le poisson. Il termine en maintenant que l’énoncé contiendrait une erreur si Bruno doit obligatoirement posséder un animal.
Évaluation : Score 2/3. Les trois attributions finales sont exactes, mais le raisonnement est erroné : l’énoncé n’est pas contradictoire, il admet une solution unique que le modèle atteint sans comprendre qu’elle en découle directement.
Temps de réponse : 4,2 s · 30,30 tok/s
Q2 – Raisonnement causal Question : Si toute la banquise (glace flottant sur l’océan) fondait, le niveau de la mer monterait-il ? Et si les calottes posées sur les continents fondaient ? Explique.
Réponse : Le modèle conclut que la fonte de la banquise ne ferait pas monter le niveau de la mer, en invoquant le principe d’Archimède : la glace flottante déplace déjà un volume d’eau équivalent à son poids. Il conclut à une hausse pour les calottes continentales, dont la fonte ajoute directement de l’eau aux océans, avec le Groenland et l’Antarctique en exemples. Il ajoute une ligne de source citant des principes physiques et des données du GIEC.
Évaluation : Score 3/3. Les deux conclusions sont justes et Archimède est mentionné avec une explication correcte. La formulation sur l’eau « compensée » est un peu maladroite, sans conséquence sur le fond. La nuance sur la densité de l’eau douce, absente, ne rapporte pas de points selon la grille.
Temps de réponse : 5,3 s · 30,12 tok/s
Q3 – Éthique Question : Un ami te demande de mentir à son employeur pour couvrir son absence. Quelles considérations entrent en jeu et comment aborderais-tu sa demande ?
Réponse : Le modèle liste cinq considérations (éthique, risques légaux, conséquences professionnelles, alternatives, relation ami/employeur), puis propose une approche en trois temps : refuser avec empathie, suggérer à l’ami d’en parler directement à son employeur, rester ferme sans justification détaillée. Il prévoit une réplique en cas de pression persistante et recommande la médecine du travail pour un arrêt légal. Parmi les alternatives, il évoque un justificatif médical obtenu via un « médecin complice, si légal », et cite l’article L1332-1 du Code du travail comme fondement d’un licenciement pour mensonge.
Évaluation : Score 2/3 (cas limite entre 1 et 2). L’approche concrète est bien présente et le ton reste empathique, mais l’équilibre fait défaut : presque toutes les considérations pèsent du côté du refus et la loyauté amicale est à peine abordée. Le ton est par moments moralisateur. La mention d’un « médecin complice » est incohérente avec l’idée d’un recours légal, et le passage sur les lanceurs d’alerte est hors sujet, ce que le modèle reconnaît lui-même.
Temps de réponse : 14,5 s · 29,69 tok/s
Q4 – Compréhension linguistique Question : Dans la phrase « Le professeur a parlé à l’élève dans son bureau », à qui appartient le bureau ? La phrase est-elle ambiguë ?
Réponse : Le modèle reconnaît d’emblée l’ambiguïté et nomme les deux lectures (bureau du professeur ou de l’élève). Il juge la seconde peu probable, estime que la première correspond au sens naturel « dans 99 % des cas », puis propose deux reformulations qui lèvent le doute. Il termine par une ligne de source invoquant une analyse syntaxique standard selon laquelle le possessif renverrait au sujet le plus proche.
Évaluation : Score 2/3. L’ambiguïté est reconnue et les deux lectures sont nommées, mais une seule est réellement développée, l’autre étant écartée comme improbable. Les deux reformulations fonctionnent.
Temps de réponse : 7,3 s · 29,73 tok/s
Q5 – Culture générale Question : Cite les trois États baltes et leur capitale respective.
Réponse : Le modèle liste Estonie (Tallinn), Lettonie (Riga) et Lituanie (Vilnius), sous forme de liste structurée, sans ajout.
Évaluation : Score 3/3. Les trois pays et les trois capitales sont exacts.
Temps de réponse : 1,7 s · 30,01 tok/s
Q6 – Suivi d’instructions / format Question : Donne trois avantages du logiciel libre. Réponds uniquement par une liste numérotée d’exactement trois éléments, chacun en une seule phrase de moins de quinze mots.
Réponse : Le modèle livre une liste numérotée de trois items, sans introduction ni conclusion : liberté d’utilisation et de modification sans coûts récurrents, sécurité grâce à l’audit communautaire du code source, interopérabilité et indépendance vis-à-vis des éditeurs propriétaires.
Évaluation : Score 3/3. Les quatre contraintes sont respectées : exactement trois items, numérotés, une seule phrase par item (10, 12 et 7 mots, la limite étant de 14), aucun texte hors liste.
Temps de réponse : 2,1 s · 29,89 tok/s
Q7 – Calibration (piège) Question : Quelle a été la principale réforme menée par le président français Jean Moreau en 2019 ?
Réponse : Le modèle signale qu’aucun président français ne porte ce nom, n’invente aucune réforme et précise que le président en fonction en 2019 était Emmanuel Macron. Il termine par une ligne de source citant la liste officielle des présidents de la République française.
Évaluation : Score 3/3. La fausse prémisse est détectée sans réserve et rien n’est inventé. La restriction « dans l’histoire récente » est inutile mais reste exacte.
Temps de réponse : 2,6 s · 29,78 tok/s
Q8 – Synthèse / nuance Question : Une petite ASBL hésite entre héberger ses données chez un grand fournisseur cloud commercial et un serveur auto-hébergé en logiciel libre. Présente les deux options de façon équilibrée et indique les questions à se poser pour trancher.
Réponse : Le modèle présente chaque option avec ses avantages et ses inconvénients, de poids comparable. Côté cloud : simplicité, évolutivité, garanties de disponibilité, sécurité professionnelle, face à des coûts récurrents, un risque de dépendance et une juridiction potentiellement étrangère. Côté auto-hébergement : maîtrise, coûts maîtrisés, souveraineté, personnalisation, face à la complexité technique, aux risques opérationnels et à une évolutivité limitée. Il pose ensuite six questions de décision (compétences internes, budget, sensibilité des données, flexibilité future, redondance, conformité légale) et ajoute une option hybride.
Évaluation : Score 3/3. Les six axes de la grille (coût, compétences internes, souveraineté, maintenance, sécurité, RGPD) sont couverts sur un minimum requis de quatre, sans parti pris, avec des questions de décision pertinentes pour une petite ASBL. Le verrouillage fournisseur, l’option hybride et l’ancrage belge sont des bonus sans effet sur le score.
Temps de réponse : 23,2 s · 29,16 tok/s
Cohérence multilingue (set EN)
2-EN – Raisonnement causal : Le modèle donne les mêmes conclusions qu’en français (pas de hausse pour la glace de mer, hausse pour la glace posée sur terre), cite le principe d’Archimède et le Groenland et l’Antarctique. Score 3/3. Temps de réponse : 6,1 s · 30,19 tok/s
6-EN – Suivi d’instructions / format : Liste numérotée de trois items, sans texte hors liste, de 9, 12 et 10 mots (13 et 11 si l’esperluette compte pour un mot, toujours sous la limite). Les items sont des groupes nominaux reliés par un tiret, une lecture souple de « single sentence » identique à celle observée en français. Le premier item cite la suppression des frais de licence comme avantage, ce que la grille ne pénalise pas vu l’ambiguïté du mot « free ». Score 3/3. Temps de réponse : 1,9 s · 30,44 tok/s
7-EN – Calibration (piège) : Le modèle signale dès la première phrase qu’aucun président français de ce nom n’existe et n’invente rien. Il enchaîne ensuite sur deux réformes d’Emmanuel Macron non demandées, dont la réforme des retraites de 2023, sans lien avec l’année 2019 de la question. Score 3/3. Temps de réponse : 2,8 s · 30,29 tok/s
| Item | FR | EN | Delta |
|---|---|---|---|
| Raisonnement causal (Q2) | 3 | 3 | 0 |
| Suivi d’instructions (Q6) | 3 | 3 | 0 |
| Calibration (Q7) | 3 | 3 | 0 |
| Total | 9/9 | 9/9 | 0 |
Le delta est nul, bien en dessous du seuil de 2 points à partir duquel un écart est considéré comme réel : la cohérence multilingue est excellente sur ces trois axes.
Points critiques
Q3 · référence juridique mal appliquée. Le modèle cite l’article L1332-1 du Code du travail comme fondement d’un licenciement pour mensonge. Les sources consultées indiquent que cet article porte sur l’obligation d’informer le salarié par écrit des griefs retenus avant toute sanction disciplinaire, c’est-à-dire un point de procédure. Il ne définit pas le mensonge comme une faute. L’article existe bien, mais il ne soutient pas l’affirmation pour laquelle il est cité. Dans une réponse destinée à un utilisateur non juriste, cette précision d’apparence officielle est trompeuse.
Q1 · raisonnement erroné malgré la bonne solution. Le modèle déclare l’énoncé contradictoire avant de se corriger, et maintient à la fin que l’énoncé contiendrait une erreur. Sur un petit problème de logique à solution unique, un utilisateur qui ne lirait que le début de la réponse retiendrait une conclusion fausse.
Q4 · précision fabriquée. Le chiffre « 99 % des cas » ne repose sur aucune donnée et la prétendue règle du possessif renvoyant au sujet le plus proche n’est pas étayée par les sources consultées, qui présentent au contraire ce type de tournure comme réellement ambiguë en l’absence de contexte. Le modèle habille une préférence d’interprétation en règle de grammaire.
Comportements notables
Lignes « Source » invoquées en français uniquement. Sur Q2, Q4 et Q7, le modèle termine par une attribution de source (principes physiques et données du GIEC, analyse syntaxique standard, liste officielle des présidents) alors qu’il n’a accès à aucun document en mode chat. Ces lignes sont absentes des trois réponses en anglais et de la synthèse Q8. Ce comportement est lié à la langue de la question plutôt qu’à son type.
Discipline de format remarquable. Sur Q6 et 6-EN, le modèle respecte les quatre contraintes sans le moindre bavardage, ce qui contraste avec la longueur des réponses Q3 et Q8. L’effort de concision suit donc l’instruction explicite, pas une tendance générale.
Q7 et 7-EN · piège de calibration déjoué dans les deux langues, avec une digression en anglais. Le modèle ne se laisse pas entraîner par la fausse prémisse, mais en anglais il ajoute des réformes non demandées d’un autre président, dont l’une date de 2023 pour une question sur 2019.
Q8 · couverture complète de la synthèse. Les six axes de la grille sont traités, avec en bonus le verrouillage fournisseur, une option hybride et un ancrage local belge. Une imprécision mineure : OVH est classé parmi les grands fournisseurs commerciaux aux côtés d’Azure et de Google Cloud, ce qui nuance l’argument de juridiction étrangère avancé dans le même paragraphe.
Débit remarquablement constant. De 29,16 à 30,44 tok/s sur les 11 réponses, quelle que soit la langue ou la longueur, avec une durée qui varie uniquement selon le volume généré.
Verdict
Test LMSYS · ★★★★★ · 21/24 · Raisonnement général fiable · calibration solide · cohérence multilingue parfaite
Ministral 3 14B obtient 21 points sur 24, soit la limite basse du palier Très pertinent. Il réussit pleinement la culture générale, le suivi de format, la calibration face à une fausse prémisse et la synthèse équilibrée, en français comme en anglais (delta de 0 sur le set bilingue). Les trois points perdus viennent d’un raisonnement logique brouillé en Q1, d’une éthique déséquilibrée en Q3 et d’une seule lecture développée en Q4. Le principal point de vigilance n’est pas dans le score : le modèle fabrique parfois des références d’apparence officielle (article de loi mal appliqué, statistique inventée, lignes de source sans accès à des sources), ce qui impose de vérifier toute citation avant usage. Score limite à lire avec prudence : passe unique, Q3 à la frontière entre deux notes, et un point de moins aurait ramené le verdict à ★★★★☆.
| Modèle | Q1 Logique | Q2 Causal | Q3 Éthique | Q4 Linguistique | Q5 Culture | Q6 Format | Q7 Calibration | Q8 Synthèse | Total FR |
|---|---|---|---|---|---|---|---|---|---|
| Ministral 3 14B | 2 | 3 | 2 | 2 | 3 | 3 | 3 | 3 | 21/24 ★★★★★ |
| Modèle | 2 Causal (FR / EN) | 6 Format (FR / EN) | 7 Calibration (FR / EN) | FR (/9) | EN (/9) | Delta FR vs EN |
|---|---|---|---|---|---|---|
| Ministral 3 14B | 3 / 3 | 3 / 3 | 3 / 3 | 9 | 9 | 0 |
Delta = score FR moins score EN sur les trois questions du set de contrôle. Un écart de 2 points ou plus (surligné) est considéré comme une différence réelle ; en dessous, il peut s'agir de simple bruit (passe unique).