
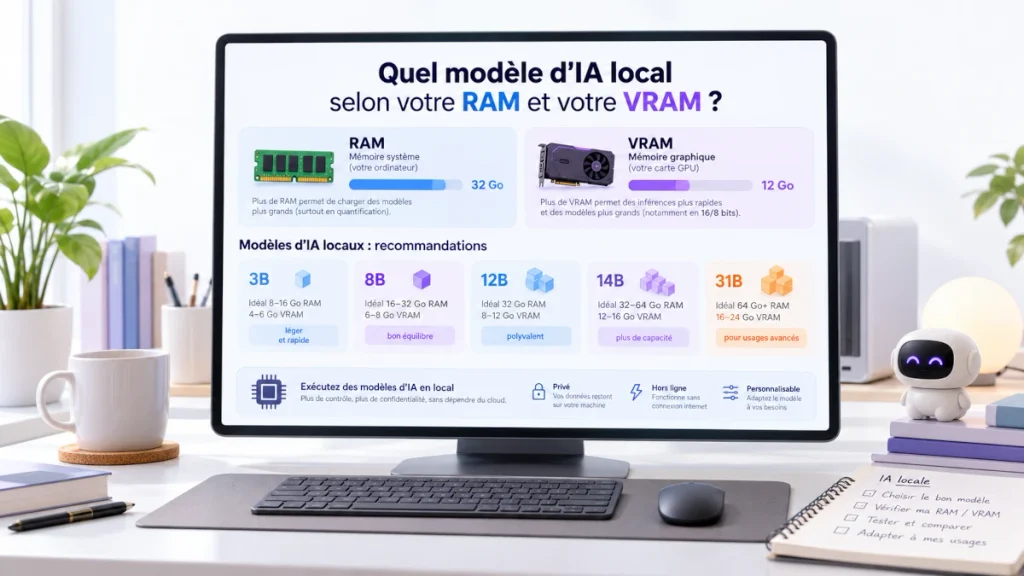
Une fois Ollama installé, une question arrive généralement très vite :
quel modèle d’intelligence artificielle mon ordinateur peut-il réellement faire fonctionner ?
Entre la RAM, la VRAM, les fameux « 3B », « 8B », « 14B » ou « 31B », la quantification Q4 et la taille du contexte, il est assez facile de s’y perdre.
Dans ce guide, nous allons volontairement nous concentrer sur les familles de modèles actuellement retenues dans nos tests sur IA-OPENSOURCE :
Ministral 3, développé par Mistral AI ;
Gemma 4, développé par Google ;
et, dans une moindre mesure, certains modèles Phi de Microsoft.
Mais avant toute chose, une distinction essentielle doit être faite :
Pouvoir charger un modèle en mémoire ne signifie pas pouvoir l’utiliser confortablement.
C’est particulièrement vrai lorsque l’ordinateur ne possède pas de carte graphique adaptée à l’intelligence artificielle.
Pourquoi nous n’abordons pas certaines configurations très haut de gamme
Dans ce guide, nous avons volontairement choisi de ne pas intégrer certaines machines pourtant particulièrement performantes pour l’IA locale.
C’est notamment le cas des mini-PC et stations spécialisées basés sur NVIDIA DGX Spark / GB10 ou sur les nouvelles plateformes AMD Ryzen AI Max / Ryzen AI Halo, capables d’exploiter de grandes quantités de mémoire unifiée pour faire fonctionner des modèles beaucoup plus importants.
AMD propose par exemple des plateformes Ryzen AI Halo pouvant disposer de 128 Go de mémoire unifiée et capables, selon le constructeur, de travailler avec des modèles pouvant atteindre des tailles très importantes.
Ces solutions sont techniquement très intéressantes, mais elles restent actuellement destinées à un public disposant d’un budget nettement supérieur à celui que nous visons dans nos guides.
Il en va de même pour les cartes graphiques NVIDIA très haut de gamme telles que les GeForce RTX 5080 et RTX 5090.
Une RTX 5090 offre notamment 32 Go de VRAM, ce qui ouvre naturellement l’accès à des modèles beaucoup plus importants. Mais son prix officiel se situe déjà autour de 2 000 € et certains modèles commercialisés atteignent des tarifs nettement supérieurs.
Notre objectif sur IA-OPENSOURCE n’est donc pas de déterminer jusqu’où l’on peut aller avec le matériel le plus puissant disponible.
Nous cherchons plutôt à répondre à une autre question :
Que peut-on réellement faire avec une IA locale en utilisant du matériel encore raisonnablement accessible au grand public, aux indépendants et aux petites entreprises ?
C’est pourquoi nos tests privilégient actuellement les configurations équipées de quantités de RAM et de VRAM plus courantes, ainsi que des modèles capables d’offrir un bon compromis entre performances, consommation et coût.
Les plateformes très haut de gamme restent intéressantes à observer, mais elles ne correspondent pas, pour le moment, au matériel que nous souhaitons recommander ou tester en priorité.
RAM et VRAM : quelle différence ?
La RAM est la mémoire principale de l’ordinateur.
Linux, le navigateur, vos applications et éventuellement le modèle d’intelligence artificielle utilisent cette mémoire.
La VRAM est la mémoire directement intégrée à la carte graphique.
On trouve aujourd’hui couramment des cartes équipées de :
4 Go
8 Go
12 Go
16 Go
24 Go de VRAM
Pour l’IA locale, la VRAM est particulièrement importante.
Une carte graphique est capable d’effectuer en parallèle un nombre considérable d’opérations mathématiques. C’est précisément le type de calcul utilisé lors de la génération de texte par un modèle d’intelligence artificielle.
Un processeur classique peut également effectuer ces calculs. Mais beaucoup plus lentement.
Un modèle IA peut fonctionner sans GPU… mais à quelle vitesse ?
Ollama permet parfaitement d’exécuter un modèle uniquement avec le processeur et la RAM.
C’est une excellente nouvelle pour découvrir l’IA locale.
Mais il faut éviter une conclusion trop rapide :
« J’ai 32 Go de RAM, donc je peux utiliser confortablement un modèle 14B. »
Techniquement, le modèle peut effectivement tenir en mémoire.
Dans la pratique, la génération peut devenir tellement lente que son utilisation interactive perd une grande partie de son intérêt. Cela dépend naturellement du processeur, de sa bande passante mémoire, du modèle et de sa quantification.
Mais, pour un guide destiné au grand public, nous préférons adopter une règle prudente :
Sans GPU dédié, les modèles de 3B à 4B constituent généralement la catégorie la plus raisonnable pour conserver une expérience interactive acceptable.
Au-delà, nous entrons davantage dans le domaine de l’expérimentation.
Pourquoi un GPU change autant les performances
Lorsqu’un modèle génère une réponse, il réalise continuellement des opérations sur des milliards de paramètres.
Un GPU moderne possède une bande passante mémoire et des capacités de calcul parallèle très supérieures à celles d’un processeur classique.
C’est pourquoi le même modèle peut donner une expérience complètement différente selon le matériel.
Un modèle 8B peut sembler parfaitement fluide lorsqu’il est entièrement chargé sur un GPU.
Le même modèle exécuté uniquement sur CPU peut demander plusieurs secondes pour générer seulement quelques mots.
Lors d’une simple démonstration, cela peut rester acceptable. Lorsqu’on utilise quotidiennement un assistant IA ou qu’on interroge des documents avec AnythingLLM, cela devient rapidement frustrant.
Le nombre de paramètres ne correspond pas directement à la mémoire nécessaire
Les noms des modèles comportent généralement un chiffre :
3B
8B
14B
31B
Il correspond approximativement au nombre de paramètres.
Ainsi :
3B = environ 3 milliards de paramètres
8B = environ 8 milliards
14B = environ 14 milliards
31B = environ 31 milliards
Mais un modèle 8B n’occupe pas nécessairement 8 Go. Sa taille dépend notamment de la précision utilisée pour stocker ses paramètres. C’est là qu’intervient la quantification.
Pourquoi la quantification est essentielle
Les modèles destinés à l’utilisation locale sont généralement proposés sous plusieurs niveaux de quantification :
Q8
Q6
Q5
Q4
IQ3
Q3
La quantification consiste à réduire la précision utilisée pour représenter les paramètres du modèle afin de diminuer fortement sa taille en mémoire.
En simplifiant :
Q8 conserve une précision très élevée, mais demande beaucoup de RAM ou de VRAM.
Q5 représente souvent un excellent compromis lorsque l’on dispose d’un peu plus de mémoire.
Q4 constitue aujourd’hui l’un des choix les plus courants pour l’IA locale, car il permet de réduire fortement les besoins en mémoire tout en conservant généralement une très bonne qualité.
Il faut en revanche faire une distinction importante entre Q3 et IQ3.
Une quantification Q3 classique réduit davantage la taille du modèle, mais la perte de qualité peut devenir sensiblement plus visible.
Les quantifications IQ3 par contre utilisent des méthodes de quantification plus sophistiquées permettant généralement de préserver davantage la qualité du modèle à une taille comparable.
En pratique, un modèle en IQ3 peut donc offrir une qualité nettement supérieure à une quantification Q3 classique, tout en restant plus compact qu’une version Q4.
On peut grossièrement retenir :
Qualité        Q4 > IQ3 > Q3
Mémoire        Q4 > IQ3 ≈ Q3
La différence exacte dépend toutefois du modèle et de la variante de quantification utilisée.
L’intérêt d’IQ3 devient particulièrement évident lorsque la VRAM constitue la principale limitation.
Prenons par exemple une carte graphique disposant de 8 Go de VRAM.
Un modèle 14B en Q4 peut être légèrement trop volumineux pour tenir entièrement sur la carte graphique.
Une version IQ3 peut réduire suffisamment sa taille pour permettre de charger une part beaucoup plus importante du modèle, voire parfois l’intégralité, dans la VRAM.
On échange alors une petite perte de qualité par rapport à Q4 contre un avantage potentiellement très important :
pouvoir utiliser un modèle plus puissant tout en conservant de bonnes performances.
C’est précisément pourquoi il ne faut pas considérer la quantification uniquement comme un moyen de « dégrader » un modèle pour économiser de la mémoire.
Bien choisie, elle permet surtout d’adapter le modèle au matériel disponible.
Dans certaines situations, un 14B en IQ3 pourra ainsi être plus intéressant qu’un 8B en Q4, à condition que le modèle plus important conserve suffisamment de qualité après quantification.
La meilleure solution reste donc de tester plusieurs combinaisons sur son propre matériel.
L’exemple de Ministral 3
La famille Ministral 3 permet de bien comprendre les différences.
Elle comprend notamment :
Ministral 3 3B
Ministral 3 8B
Ministral 3 14B
Dans Ollama, leurs versions quantifiées occupent approximativement plusieurs gigaoctets :
| Modèle | Taille approximative |
|---|---|
| Ministral 3 3B | environ 3 Go |
| Ministral 3 8B | environ 6 Go |
| Ministral 3 14B | environ 9 Go |
Ces tailles donnent déjà une première indication sur la mémoire nécessaire. Mais elles ne disent rien sur la vitesse de génération. Et c’est précisément là que la présence d’un GPU devient déterminante.
Sans GPU : notre recommandation change
Lorsqu’un ordinateur ne dispose pas d’une carte graphique capable d’accélérer les modèles, nous ne conseillons pas de choisir un modèle uniquement en fonction de la quantité de RAM disponible.
Une machine disposant de 32 ou 64 Go de RAM peut parfaitement charger un modèle de 14B ou plus.
Cela ne signifie cependant pas que l’expérience sera satisfaisante.
Pour un utilisateur souhaitant réellement discuter avec son modèle, nous privilégierions essentiellement :
Ministral 3 3B
Phi-3 Mini
ou d’autres modèles comparables autour de 3 à 4 milliards de paramètres. Ils représentent selon nous une limite beaucoup plus réaliste pour une utilisation CPU grand public.
Avec 8 Go de RAM et sans GPU
Sur une machine équipée de seulement 8 Go de RAM, le choix est relativement simple.
Nous privilégierions :
Ministral 3 3B
Phi-3 Mini
Il faut évidemment conserver suffisamment de mémoire pour Linux et les applications.
Un Ministral 3 3B permet déjà :
- de découvrir Ollama ;
- de discuter avec une IA locale ;
- de faire du résumé ;
- de tester de petites tâches rédactionnelles ;
- d’expérimenter un RAG simple.
Pour découvrir l’IA locale sans GPU, c’est déjà une excellente base.
Et avec 16, 32 ou 64 Go de RAM sans GPU ?
C’est ici que notre recommandation diffère de ce que pourrait laisser penser une simple comparaison des tailles.
Avec 16 Go de RAM, il est techniquement possible de charger un modèle 8B.
Avec 32 Go, un 14B devient parfaitement possible.
Avec 64 Go, des modèles beaucoup plus lourds peuvent entrer en mémoire.
Mais nous ne les conseillerions pas pour un usage interactif classique sans accélération GPU.
Pourquoi ?
Parce qu’une grande quantité de RAM résout uniquement le problème du stockage du modèle en mémoire.
Elle ne transforme pas le processeur en GPU.
Un 8B ou un 14B peut donc être chargé correctement tout en générant les réponses à une vitesse extrêmement faible.
Dans AnythingLLM, le problème peut être encore plus visible lorsqu’il faut traiter un contexte documentaire avant de générer la réponse.
Pour cette raison, même avec :
16 Go
32 Go
64 Go de RAM
nous resterions principalement sur un 3B ou 4B pour une utilisation quotidienne sans GPU.
Un modèle 8B ou supérieur peut néanmoins être intéressant pour :
- réaliser ponctuellement des tests ;
- comparer la qualité de plusieurs modèles ;
- effectuer des traitements où la vitesse importe peu ;
- lancer une génération longue sans attendre devant l’écran.
Mais ce n’est plus, selon nous, la meilleure expérience pour un assistant interactif.
La RAM reste néanmoins importante sans GPU
Cela ne signifie pas qu’avoir 32 Go de RAM est inutile.
Une quantité importante de mémoire permet :
- d’utiliser un contexte plus important ;
- de faire tourner AnythingLLM ou Open WebUI en parallèle ;
- de traiter davantage de documents ;
- d’éviter le recours au swap ;
- de conserver plusieurs applications ouvertes ;
- d’expérimenter occasionnellement des modèles plus lourds.
Mais elle ne compense pas la différence de puissance de calcul entre CPU et GPU.
Avec un GPU de 4 Go
Avec une carte graphique de 4 Go de VRAM, nous privilégierions encore :
Ministral 3 3B
Phi-3 Mini
La différence avec le CPU seul peut déjà être spectaculaire.
Le modèle peut alors être chargé en grande partie ou entièrement sur le GPU et produire ses réponses beaucoup plus rapidement. Pour découvrir l’IA locale sur une ancienne carte graphique, cette catégorie reste donc intéressante.
Avec 6 Go de VRAM
À partir de 6 Go de VRAM, Ministral 3 8B commence à devenir envisageable.
Sa version Q4 occupe approximativement 6 Go. Nous sommes toutefois très très proches de la limite.
Le modèle n’est pas le seul élément à utiliser la mémoire vidéo. Le contexte et le KV cache consomment également de la VRAM.
Une carte 6 Go peut donc utiliser Ministral 3 8B, mais une partie du traitement sera déportée vers la RAM.
Nous aurions donc deux options :
Ministral 3 3B → priorité à la vitesse
Ministral 3 8B → priorité aux capacités
8 Go de VRAM : le vrai point d’entrée confortable
À notre avis, 8 Go de VRAM constituent aujourd’hui un excellent point de départ pour utiliser sérieusement une IA locale.
Cette quantité permet notamment de faire fonctionner confortablement :
Ministral 3 8BLe modèle occupe approximativement 6 Go dans sa quantification Q4.
Il reste donc une certaine marge pour le contexte et le KV cache.
Avec cette configuration, on peut déjà envisager très sérieusement :
- assistant conversationnel ;
- résumé ;
- rédaction ;
- traduction ;
- analyse de documents ;
- RAG avec AnythingLLM ;
- petits travaux de programmation.
Pour beaucoup d’utilisateurs, un bon modèle 8B entièrement chargé sur le GPU représente déjà un excellent équilibre.
Gemma 4 avec 8 Go de VRAM
Gemma 4 utilise une gamme différente de Ministral 3 :
Gemma 4 E2B
Gemma 4 E4B
Gemma 4 12B
Gemma 4 26B A4B
Gemma 4 31B
Les plus petits modèles Gemma 4 peuvent parfaitement trouver leur place sur une carte de 8 Go.
Gemma 4 12B, en revanche, se situe déjà autour de la limite de cette capacité selon sa quantification.
Il peut fonctionner, mais la marge disponible pour le contexte et le KV cache devient très réduite.
Nous considérerions donc plutôt 12 Go de VRAM comme un niveau confortable pour Gemma 4 12B.
Avec 12 Go de VRAM
12 Go constituent une configuration particulièrement intéressante.
On peut y faire fonctionner confortablement :
Ministral 3 8B
Ministral 3 14B
Gemma 4 12B
Phi-3 Medium
C’est probablement l’une des catégories offrant actuellement le meilleur équilibre entre coût du matériel et choix des modèles.
Ministral 3 14B peut alors fonctionner sans devoir être fortement déporté vers la mémoire système.
Gemma 4 12B devient lui aussi beaucoup plus confortable.
Avec 16 Go de VRAM
À 16 Go de VRAM, Ministral 3 14B et Gemma 4 12B deviennent extrêmement confortables.
On peut également commencer à expérimenter des modèles plus lourds tels que :
Gemma 4 26B A4Bselon leur quantification. Une partie de l’exécution peut éventuellement être déportée vers la RAM.
Mais contrairement à une exécution entièrement sur CPU, une grande partie du calcul continue ici d’être réalisée par le GPU. L’expérience peut donc rester intéressante.
Comprendre le cas particulier de Gemma 4 26B A4B
Gemma 4 26B A4B utilise une architecture Mixture-of-Experts, ou MoE.
Le modèle contient un grand nombre de paramètres, mais seulement une partie est activée pour générer chaque token.
Cela permet de réduire le coût de calcul par rapport à un modèle dense utilisant tous ses paramètres simultanément.
Mais attention :
Cela ne signifie pas que seuls les paramètres actifs doivent être chargés en mémoire.
L’ensemble des experts doit rester disponible.
Le besoin en VRAM reste donc nettement supérieur à celui d’un simple modèle 4B.
Avec 24 Go de VRAM
Avec 24 Go de mémoire vidéo, on entre dans la catégorie des véritables stations IA locales.
On peut notamment envisager confortablement :
Ministral 3 14B
Gemma 4 12B
Gemma 4 26B A4B
et expérimenter :
Gemma 4 31Bselon la quantification utilisée et la taille du contexte.
À ce niveau de matériel, les contraintes commencent réellement à diminuer.
Notre tableau de référence pour la VRAM
Pour simplifier, nous utiliserions les recommandations suivantes :
| VRAM | Modèles conseillés |
|---|---|
| Pas de GPU | 3B–4B maximum conseillé |
| 4 Go | Ministral 3 3B, Phi-3 Mini |
| 6 Go | Ministral 3 3B, Ministral 3 8B avec compromis |
| 8 Go | Ministral 3 8B, petits Gemma 4 |
| 12 Go | Ministral 3 14B, Gemma 4 12B |
| 16 Go | Ministral 3 14B, Gemma 4 12B, essais Gemma 4 26B (en IQ3) |
| 24 Go | Gemma 4 26B, Gemma 4 31B selon quantification |
Ces valeurs ne représentent pas des limites techniques absolues.
Elles représentent plutôt les catégories dans lesquelles nous considérons que l’expérience commence à être réellement intéressante.
Et le tableau RAM sans GPU ?
Nous préférons ici ne pas établir un tableau du type :
16 Go = 8B
32 Go = 14B
64 Go = 30B
car cela pourrait être trompeur.
En termes de capacité mémoire, ces affirmations peuvent être techniquement correctes.
En termes d’expérience utilisateur, elles le sont beaucoup moins.
Nous retiendrons plutôt :
| RAM sans GPU | Recommandation pratique |
|---|---|
| 8 Go | 1B à 3B |
| 16 Go | 3B à 4B conseillé |
| 32 Go | 3B à 4B conseillé ; 8B+ pour expérimentation |
| 64 Go | 3B à 4B pour le confort ; modèles supérieurs possibles mais très lents lors de la génération |
La quantité de RAM détermine ce qui peut être chargé. Le CPU détermine en grande partie à quelle vitesse ce modèle pourra répondre.
Pourquoi le contexte compte aussi
Un modèle n’utilise pas uniquement de la mémoire pour ses paramètres.
Il doit également conserver le contexte de la conversation.
C’est notamment le rôle du KV cache. Plus le contexte augmente, plus la consommation mémoire augmente.
Ministral 3 peut par exemple accepter des contextes très importants.
Mais utiliser systématiquement le contexte maximal n’a aucun intérêt pour la plupart des usages.
Pour une conversation ou du RAG classique, un contexte raisonnable permettra :
- d’économiser de la mémoire ;
- d’améliorer les performances ;
- d’éviter les déports CPU inutiles.
Pour le RAG, un modèle 8B peut largement suffire
C’est également une raison pour laquelle il n’est pas toujours nécessaire de chercher le plus gros modèle possible.
Avec AnythingLLM, les documents sont d’abord analysés et les passages pertinents sont récupérés.
Le modèle reçoit ensuite ces informations dans son contexte. Il n’a donc pas besoin de mémoriser l’intégralité des documents. Un modèle comme Ministral 3 8B peut fournir d’excellents résultats dans ce type de scénario.
Passer à 14B ou 30B peut dans certains cas améliorer certaines réponses complexes.
Mais l’amélioration n’est pas nécessairement proportionnelle aux ressources supplémentaires nécessaires.
Un 8B rapide vaut parfois mieux qu’un 14B lent
Imaginons un ordinateur équipé d’une carte graphique de 8 Go.
Deux solutions sont possibles :
Ministral 3 8B entièrement sur le GPUou :
Ministral 3 14B partiellement sur GPU et partiellement en RAMLe 14B peut produire de meilleures réponses dans certaines situations.
Mais le 8B peut être beaucoup plus rapide.
Dans un usage quotidien, une réponse produite immédiatement est souvent préférable à une amélioration légère obtenue au prix d’une attente importante.
Quelques configurations types
PC sans GPU dédié
Notre recommandation :
Ministral 3 3B
Phi-3 Mini
Même avec beaucoup de RAM, nous resterions sur cette catégorie pour un assistant interactif.
GPU 4 Go
Ministral 3 3B
Phi-3 Mini
Très bonne configuration pour commencer.
GPU 8 Go + 16 ou 32 Go de RAM
Notre premier choix :
Ministral 3 8BC’est déjà une excellente configuration pour une IA locale polyvalente.
GPU 12 Go + 32 Go de RAM
Nous testerions :
Ministral 3 14B
Gemma 4 12B
Cette catégorie permet déjà des comparaisons très intéressantes entre modèles.
GPU 16 Go + 32 Go de RAM
Nous privilégierions :
Ministral 3 14B
Gemma 4 12B
avec la possibilité d’expérimenter Gemma 4 26B selon sa quantification.
GPU 24 Go + 64 Go de RAM
On peut alors envisager :
Gemma 4 26B A4B
Gemma 4 31B
tout en conservant naturellement les modèles plus légers lorsqu’ils suffisent à la tâche.
Pourquoi nous testons principalement Ministral 3 et Gemma 4
Sur IA-OPENSOURCE, nous avons volontairement choisi de ne pas multiplier les familles de modèles.
Nous nous concentrons actuellement principalement sur :
Ministral 3
Gemma 4
avec quelques essais complémentaires autour de Phi.
Cette approche nous permet de comparer plus sérieusement plusieurs tailles de modèles et plusieurs architectures.
Ministral 3 propose notamment une gamme particulièrement lisible :
3B
8B
14B
Gemma 4 permet ensuite d’explorer d’autres architectures et des modèles plus importants.
Notre objectif n’est donc pas de tester tous les modèles disponibles.
Nous cherchons plutôt à comprendre quels modèles apportent réellement quelque chose selon le matériel et l’utilisation.
Comment vérifier si Ollama utilise réellement le GPU ?
Ollama propose une commande très pratique :
ollama psCommencez par lancer votre modèle :
ollama run ministral-3:8bPuis ouvrez un second terminal :
ollama psVous pourrez vérifier si le modèle est exécuté :
principalement sur GPU
partiellement sur GPU
ou sur CPU
Cette information explique souvent immédiatement pourquoi un modèle est rapide ou extrêmement lent.
La règle simple à retenir
S’il fallait retenir une seule idée de ce guide, ce serait celle-ci :
Ne choisissez jamais un modèle uniquement parce qu’il tient dans votre RAM.
La mémoire détermine si le modèle peut être chargé.
La puissance de calcul et la bande passante mémoire déterminent si vous pourrez réellement l’utiliser confortablement.
Pour une machine sans GPU adapté :
3B à 4B représentent selon nous la zone la plus raisonnable pour un usage interactif.
Avec un GPU :
cherchez en priorité un modèle capable de tenir entièrement, ou presque entièrement, dans votre VRAM.
Un modèle 8B parfaitement fluide donnera souvent une expérience beaucoup plus agréable qu’un modèle 14B ou 30B fonctionnant au ralenti.
Le meilleur modèle local n’est donc pas celui qui possède le plus de paramètres.
C’est celui qui offre le meilleur équilibre entre :
qualité des réponses, vitesse, quantité de mémoire disponible et usage réel.